
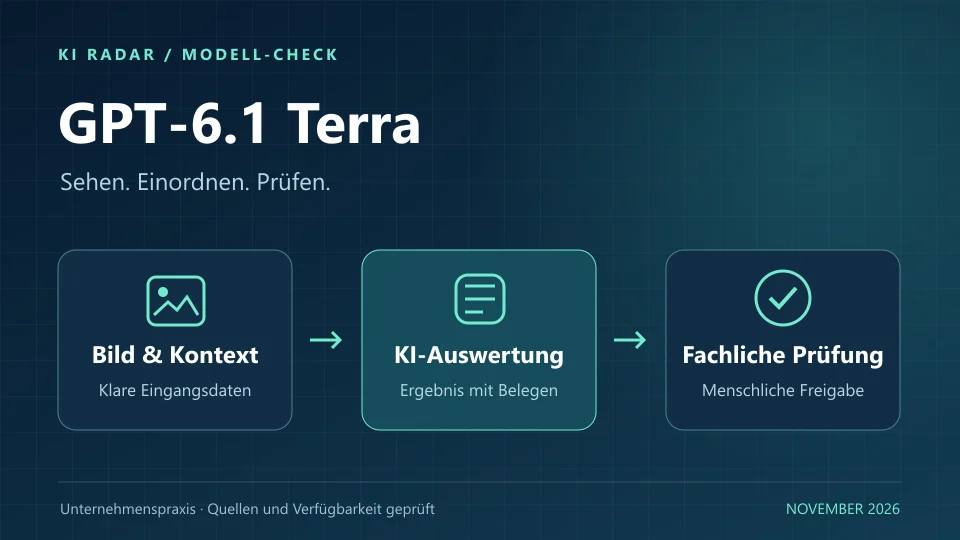
Was sich mit dem Oktober-Release verändert
Im offiziellen OpenAI-Changelog ist GPT-6.1 Terra für den 26. Oktober 2026 verzeichnet. OpenAI positioniert das Modell für visuelles Schlussfolgern, präzise Computersteuerung und verständliche Texte. Das macht es für Aufgaben interessant, bei denen ein Assistent Informationen aus Bildern und einer Anwendung zusammenführen muss. Diese Einordnung stützt sich auf die Dokumentation; sie ist kein eigener Leistungstest von KI-Radar.
Ein typisches Beispiel ist ein Produktteam, das Fotos einer Lieferung mit einem Artikelkatalog abgleicht. Ein anderes ist eine Fachabteilung, die Informationen aus einer Bildschirmansicht in einen strukturierten Entwurf überführt. In beiden Fällen reicht eine sprachlich gute Antwort nicht aus. Das System muss das richtige Objekt erkennen, Unsicherheiten benennen und das Ergebnis an der passenden Stelle weitergeben. Genau diese Verbindung sollte der Pilot prüfen.
Bildverständnis und Bilderzeugung auseinanderhalten
Die Modellseite zu GPT-6.1 Terra nennt Text und Bilder als Eingaben; die native Ausgabe ist Text. Ein visuell arbeitendes Modell ist deshalb nicht automatisch ein Bildgenerator. Bilderzeugung kann Teil eines Werkzeugs sein, muss dann aber als eigener Verarbeitungsschritt betrachtet werden. Auch die Steuerung einer Anwendung benötigt eine passende technische Umgebung.
Für die Beschaffung hilft eine einfache Aufgabenbeschreibung: Welche Information liegt als Bild vor? Welche Entscheidung soll daraus entstehen? Welches Ergebnis muss ein Mensch kontrollieren können? Eine Produktzuordnung braucht beispielsweise eine Artikelnummer und die dazugehörige Fundstelle. Eine technische Zeichnung braucht eindeutige Bezüge zu Maßen und Bauteilen. Bleibt ein Detail unleserlich, ist eine ausdrücklich offene Frage wertvoller als eine plausibel ergänzte Zahl.
Besonders aussagekräftig sind Gegenbeispiele. Zwei ähnliche Verpackungen, ein abgeschnittenes Etikett oder eine veraltete Bildschirmansicht zeigen schneller, wo der Ablauf Grenzen hat. Solche Fälle gehören von Anfang an in das Testset. Sie verhindern, dass eine Vorführung mit wenigen gut lesbaren Bildern als Nachweis für den gesamten Arbeitsalltag gilt.
Die API-Preise richtig lesen
OpenAIs aktuelle API-Preistabelle nennt im Standardtarif für Anfragen bis 272.000 Eingabe-Token 1 USD je Million Eingabe-Token, 0,05 USD für zwischengespeicherte Eingaben und 5 USD je Million Ausgabe-Token. Das Schreiben des Caches kostet separat: 1,25 USD bei 30 Minuten beziehungsweise 2,50 USD bei zwölf Stunden Speicherung. Die Angaben sind API-Preise und keine ChatGPT-Abonnementpreise.
Ein vereinfachtes Rechenbeispiel: Werden für eine Aufgabe insgesamt 100.000 normale Eingabe-Token und 10.000 abrechenbare Ausgabe-Token erfasst, ergeben sich 0,15 USD reine Modellkosten. Werkzeugaufrufe, Speicher, Ausführungsumgebung, Wiederholungen und menschliche Prüfung sind darin nicht enthalten. Das Beispiel dient der Kalkulation; es ist keine Zusage für die Kosten einer Bildanalyse oder eines Agentenlaufs.
Lange Eingaben verändern die Rechnung. Oberhalb von 272.000 Eingabe-Token steigen laut Modellseite die Eingabe- und Cache-Raten für die gesamte Anfrage auf das Doppelte, die Ausgaberate auf das Eineinhalbfache. Regionale Verarbeitung und andere Geschwindigkeitsstufen können weitere Aufschläge auslösen. Deshalb sollte das Budget aus tatsächlich gemessenen vollständigen Aufträgen entstehen. Ein günstiger Tokenpreis allein sagt wenig über den Preis eines freigegebenen Ergebnisses aus.
Computer Use braucht einen klaren Arbeitsauftrag
Für Werkzeugaufrufe verlangt die Terra-Dokumentation die Responses API. OpenAIs Computer-Use-Leitfaden beschreibt außerdem den Zusammenschluss des Modells mit einer Browser- oder Desktop-Laufzeit. Die Modellfreigabe allein stellt daher noch keine fertige Automatisierung bereit.
KI-Radar empfiehlt, die erste Aufgabe auf einen kleinen Ablauf zu begrenzen. Der Assistent darf etwa einen Entwurf in einer Testanwendung vorbereiten; ein Beschäftigter entscheidet anschließend über das Speichern oder Weitergeben. Der Auftrag legt fest, welche Anwendung genutzt werden darf, welche Felder relevant sind und wann der Assistent anhalten soll. Ein unerwarteter Dialog oder eine abweichende Kundennummer wird so zu einem definierten Prüfpunkt.
Wichtig ist auch ein überprüfbarer Abschluss. Statt nur „erledigt“ zu melden, sollte das Ergebnis zeigen, welche Datensätze bearbeitet wurden und welche offenblieben. Ein Bildschirmfoto kann dabei helfen, ersetzt aber keinen Vergleich mit den gespeicherten Werten. Besonders bei wiederholten Aufträgen muss außerdem erkennbar sein, ob bereits vorbereitete Daten erneut verarbeitet wurden.
Ein Pilotbeispiel: Produktbilder einem Katalog zuordnen
Das folgende Beispiel ist ein redaktioneller Testvorschlag. Ein Händler stellt einen freigegebenen Katalog und eine kleine Sammlung eigener Produktfotos bereit. Zu jedem Foto existiert eine fachlich geprüfte richtige Zuordnung. Das Testset enthält zusätzlich Varianten, die sich nur durch Größe, Farbe oder Verpackung unterscheiden, sowie Fälle ohne passenden Katalogeintrag. Personenbezogene Daten werden für diesen Versuch nicht benötigt.
Der Assistent liefert je Bild eine vorgeschlagene Artikelnummer, die beobachteten Unterscheidungsmerkmale und offene Fragen. Eine zweite Person prüft die Zuordnung, ohne die ursprüngliche Lösung vorher zu sehen. Gemessen werden richtige Zuordnungen, übersehene Varianten, unnötige Rückfragen und die Zeit bis zur Freigabe. Die wichtigste Fehlergruppe sind selbstsicher falsche Zuordnungen, weil sie in der späteren Bearbeitung leicht weiterverwendet werden.
Das Team vergleicht denselben Auftrag anschließend mit dem bisherigen Verfahren. Ein Modell ist dann hilfreich, wenn es den gesamten Ablauf verbessert. Wird die Erstbearbeitung schneller, die Nachkontrolle aber deutlich aufwendiger, muss die Aufgabenbeschreibung enger werden. Denkbar sind bessere Bilder, ein kleinerer Katalog oder eine Regel, nach der ähnliche Varianten grundsätzlich an Menschen gehen.
Qualität, Laufzeit und Rechte gemeinsam bewerten
OpenAIs Modellleitfaden empfiehlt für Terra den Einstieg mit mittlerem Reasoning-Aufwand und den Vergleich auf repräsentativen Bildern und Arbeitsabläufen. Höherer Aufwand sollte sich durch ein besseres Ergebnis rechtfertigen. Die verfügbare Einstellung ist keine Qualitätsgarantie für den konkreten Unternehmensprozess.
Für den eigenen Vergleich sollten Eingangsdaten, Rechte, Ausgabeformat und Abnahmekriterien gleich bleiben. Sonst wird schnell eine veränderte Aufgabenstellung mit einem besseren Modell verwechselt. Hilfreich ist ein Protokoll, das Modell, Einstellungen, Laufzeit, Kosten und manuelle Korrekturen je Auftrag festhält. Eine Stichprobe sollte bewusst nach Änderungen an Anwendung, Vorlage oder Bildmaterial wiederholt werden.
Bei ausführenden Abläufen bewertet das Team zusätzlich die Grenzen der Befugnisse. Lesen, einen Entwurf erstellen und eine Änderung veröffentlichen sind unterschiedliche Aufgaben. Eine Person muss erkennen können, was bereits geschehen ist und was noch auf Freigabe wartet. Für sensible Fachentscheidungen bleibt die fachlich verantwortliche Stelle zuständig. Dieser organisatorische Teil lässt sich auch dann vorbereiten, wenn die technische Integration noch im Aufbau ist.
Fazit: auf den Preis des geprüften Ergebnisses schauen
GPT-6.1 Terra ist ein aktueller Kandidat für Arbeitsabläufe mit Bildern, Bildschirmansichten und Texten. Der nächste sinnvolle Schritt ist ein Vergleich mit eigenen, wiederkehrenden Aufgaben. Ein begrenzter Pilot liefert dafür bessere Entscheidungsgrundlagen als ein pauschaler Modellwechsel: Wie viele Ergebnisse sind richtig, welche Fälle brauchen Rückfragen und wie viel Arbeit bleibt bis zur Freigabe? Erst aus diesen Antworten wird ein belastbarer Geschäftsnutzen.
Vergleich
GPT-6.1 Terra: Eckdaten für die Planung
FAQ
Häufige Fragen
Erzeugt GPT-6.1 Terra selbst Bilder?
Die native Ausgabe des Modells ist laut Dokumentation Text. Es kann Bilder als Eingabe auswerten. Bilderzeugung über ein zusätzliches Werkzeug ist ein gesonderter Schritt.
Sind die API-Preise im ChatGPT-Abo enthalten?
API-Nutzung und ChatGPT-Abonnements haben unterschiedliche Abrechnungsmodelle. Die hier genannten Tokenpreise beschreiben die Standard-API und erlauben keinen Rückschluss auf enthaltene Abo-Aufgaben.
Was sollte ein erster Pilot messen?
Richtige Ergebnisse, übersehene Fehler, Rückfragen, Gesamtlaufzeit, manuelle Prüfung und vollständige Auftragskosten. Bei Computer Use kommen die eingehaltenen Aktionsgrenzen hinzu.
Quellen und Herstellerseiten